Domain etikettiert.de kaufen?
Wir ziehen mit dem Projekt
etikettiert.de um.
Sind Sie am Kauf der Domain
etikettiert.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain etikettiert.de kaufen?
Wie können Produkte effizient und präzise etikettiert werden, um eine klare Kennzeichnung und einfache Identifizierung zu gewährleisten?
Produkte können effizient und präzise durch den Einsatz von Etikettiermaschinen mit hoher Geschwindigkeit und Genauigkeit etikettiert werden. Die Verwendung von Barcode- oder RFID-Technologie ermöglicht eine klare Kennzeichnung und einfache Identifizierung der Produkte. Zudem sollte auf eine einheitliche und gut sichtbare Platzierung der Etiketten geachtet werden, um Verwechslungen zu vermeiden. **
Was sind die wichtigsten Methoden zur Klassifizierung von Daten?
Die wichtigsten Methoden zur Klassifizierung von Daten sind Supervised Learning, Unsupervised Learning und Semi-Supervised Learning. Supervised Learning verwendet gelabelte Daten, um Modelle zu trainieren, während Unsupervised Learning ungelabelte Daten verwendet, um Muster zu identifizieren. Semi-Supervised Learning kombiniert beide Ansätze und nutzt eine Mischung aus gelabelten und ungelabelten Daten für das Training von Modellen. **

Ähnliche Suchbegriffe für Datenleitungs-Daten
Top-Angebote
Produkte zum Begriff Datenleitungs-Daten:
-
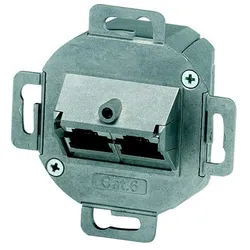
Mennekes Daten-Anschlussdose 41452Aufputzmontage=neinUnterputzmontage=neinKanaleinbau=neinBodentank/Unterflurmontage=neinBefestigungsart=schraubenZusammenstellung=Basiselement mit KomplettgehäuseSteckverbindertyp=2x RJ45 8(4)Mit Buchsen/Kupplungen=jaGeeignet für Anzahl Buchsen/Kupplungen=2Kategorie=6Farbe=sonstigeAnschlussart=LSABuchsen geschirmt=neinGehäuse geschirmt=neinSeparater Erdungsanschluss=neinMit Textfeld=jaDesignfähig=jaSeparate Kabelzugentlastung=jaMontageart Schirmanschluss=ohneAuslassrichtung=untenMit Staubschutz=neinMit Abschlusswiderstand=neinSchutzart (IP)=IP44Mechanische Codierung=neinFarbcodierung=neinGerätebreite=70 mmGerätehöhe=40 mmGerätetiefe=70 mm53,82 €*Versand: 5,99 €Sichere Weiterleitung zum Anbieter
-
Fischer, Tin: Linke Daten, Rechte DatenLinke Daten, Rechte Daten , Warum wir nur das sehen, was wir sehen wollen , Lager, Buchsen & Dichtungen > Radaufhängung, Federung & Lenkung , Erscheinungsjahr: 20220402, Produktform: Leinen, Autoren: Fischer, Tin, Seitenzahl/Blattzahl: 240, Themenüberschrift: BUSINESS & ECONOMICS / Statistics, Keyword: Statistiken; Gefühlte Wahrheit; Wahrheit; Fake News; Gesundheit; Gesellschaft; Grüne; Umwelt; Klima; Wirtschaft; Geld; Politik; Mario Mensch; Wirtschaftsstatistik; Statistik; Einwanderung, Fachschema: Analyse / Datenanalyse~Datenanalyse~Migration (soziologisch)~Wanderung (soziologisch)~Zuwanderung~Forschung (wirtschafts-, sozialwissenschaftlich) / Sozialforschung~Sozialforschung~Empirische Sozialforschung~Sozialforschung / Empirische Sozialforschung~Umwelt / Politik, Wirtschaft, Planung~Ökonometrie~Statistik / Wirtschaftsstatistik~Wirtschaftsstatistik, Fachkategorie: Datenanalyse, allgemein~Sozialforschung und -statistik~Grüne Politik / Ökopolitik / Umweltschutz~Ökonometrie und Wirtschaftsstatistik~Wahrscheinlichkeitsrechnung und Statistik, Warengruppe: HC/Politikwissenschaft/Soziologie/Populäre Darst., Fachkategorie: Migration, Einwanderung und Auswanderung, Thema: Auseinandersetzen, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Hoffmann und Campe Verlag, Verlag: Hoffmann und Campe Verlag, Verlag: Hoffmann und Campe Verlag GmbH, Länge: 215, Breite: 144, Höhe: 26, Gewicht: 402, Produktform: Gebunden, Genre: Sozialwissenschaften/Recht/Wirtschaft, Genre: Sozialwissenschaften/Recht/Wirtschaft, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0002, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 267813525,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter

-
Was sind die verschiedenen Methoden zur Klassifizierung von Objekten oder Daten?
Die verschiedenen Methoden zur Klassifizierung von Objekten oder Daten umfassen Supervised Learning, Unsupervised Learning und Semi-Supervised Learning. Beim Supervised Learning werden Trainingsdaten mit bekannten Labels verwendet, um ein Modell zu trainieren. Beim Unsupervised Learning werden keine Labels verwendet, das Modell identifiziert automatisch Muster und Gruppierungen in den Daten. Beim Semi-Supervised Learning werden sowohl gelabelte als auch ungelabelte Daten verwendet, um ein Modell zu trainieren. **
-
Was sind die gängigen Methoden zur Klassifizierung von Objekten oder Daten?
Die gängigen Methoden zur Klassifizierung von Objekten oder Daten sind Supervised Learning, Unsupervised Learning und Semi-Supervised Learning. Supervised Learning verwendet gelabelte Daten, um ein Modell zu trainieren, das dann neue Daten klassifizieren kann. Unsupervised Learning gruppiert Daten basierend auf Ähnlichkeiten, ohne dass gelabelte Daten benötigt werden. Semi-Supervised Learning kombiniert Elemente von Supervised und Unsupervised Learning, indem es sowohl gelabelte als auch ungelabelte Daten verwendet. **
-
Was sind die gängigsten Methoden zur Klassifizierung von Daten in der Informatik?
Die gängigsten Methoden zur Klassifizierung von Daten in der Informatik sind die hierarchische Klassifizierung, die kategorische Klassifizierung und die numerische Klassifizierung. Bei der hierarchischen Klassifizierung werden Daten in einer Baumstruktur organisiert, bei der kategorischen Klassifizierung werden Daten in verschiedene Kategorien eingeteilt und bei der numerischen Klassifizierung werden Daten anhand von Zahlenwerten klassifiziert. **
-
Was sind die verschiedenen Methoden zur Klassifizierung von Daten in der Informatik?
Die verschiedenen Methoden zur Klassifizierung von Daten in der Informatik sind Supervised Learning, Unsupervised Learning und Semi-Supervised Learning. Beim Supervised Learning werden Daten mit bereits bekannten Labels trainiert, beim Unsupervised Learning werden Muster und Strukturen in den Daten identifiziert, und beim Semi-Supervised Learning werden sowohl gelabelte als auch ungelabelte Daten verwendet. Jede Methode hat ihre eigenen Vor- und Nachteile und wird je nach Anwendungsfall ausgewählt. **

Was sind die gängigsten Methoden zur Klassifizierung von Daten in der Informatik?
Die gängigsten Methoden zur Klassifizierung von Daten in der Informatik sind die hierarchische Klassifizierung, die k-means-Clustering-Methode und die Entscheidungsbaum-Methode. Bei der hierarchischen Klassifizierung werden Daten in hierarchische Gruppen unterteilt, während bei k-means Daten in k Gruppen mit ähnlichen Merkmalen eingeteilt werden. Die Entscheidungsbaum-Methode teilt Daten basierend auf Entscheidungen in einem Baumdiagramm auf. **
Was sind die gängigsten Methoden zur Klassifizierung von Daten in der Informatik?
Die gängigsten Methoden zur Klassifizierung von Daten in der Informatik sind die Supervised Learning, Unsupervised Learning und Semi-Supervised Learning. Supervised Learning verwendet gelabelte Daten, um Muster zu erkennen und Vorhersagen zu treffen. Unsupervised Learning findet Muster in unlabeled Daten, während Semi-Supervised Learning eine Kombination aus beidem ist. **
Top-Angebote
Produkte zum Begriff Datenleitungs-Daten:
-
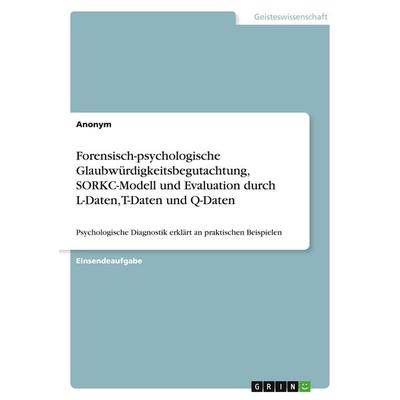
Forensisch-psychologische Glaubwürdigkeitsbegutachtung, SORKC-Modell und Evaluation durch L-Daten, T-Daten und Q-Daten, Taschenbuch von Anonymous,Forensisch-psychologische Glaubwürdigkeitsbegutachtung, Sorkc-modell Und Evaluation Durch L-daten, T-daten Und Q-daten, Taschenbuch Von Anonymous, Grin, 978-3-346-51308-3, Seitenanzahl: 249,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Yarbo Ersatz Daten CenterBesonderheiten des Daten CentersLiefert präzise Navigationsdaten an den Yarbo Core Verbindung mit Ihrem Heimnetzwerk über Ethernet (30-m-Kabel im Lieferumfang enthalten) Ausgestattet mit RTK-, Bluetooth- und HaLow-WLAN-AntennenLieferumfang:1x Yarbo Ersatz Daten CenterInformationen und Downloads: Yarbo Schnellstartanleitung (engl.) Yarbo Produktvorstellung (engl.) Yarbo Bedienungsanleitung (engl.)...329,00 €*Versand: 159,00 €Sichere Weiterleitung zum Anbieter
-
Mennekes Daten-Anschlussdose 41452Aufputzmontage=neinUnterputzmontage=neinKanaleinbau=neinBodentank/Unterflurmontage=neinBefestigungsart=schraubenZusammenstellung=Basiselement mit KomplettgehäuseSteckverbindertyp=2x RJ45 8(4)Mit Buchsen/Kupplungen=jaGeeignet für Anzahl Buchsen/Kupplungen=2Kategorie=6Farbe=sonstigeAnschlussart=LSABuchsen geschirmt=neinGehäuse geschirmt=neinSeparater Erdungsanschluss=neinMit Textfeld=jaDesignfähig=jaSeparate Kabelzugentlastung=jaMontageart Schirmanschluss=ohneAuslassrichtung=untenMit Staubschutz=neinMit Abschlusswiderstand=neinSchutzart (IP)=IP44Mechanische Codierung=neinFarbcodierung=neinGerätebreite=70 mmGerätehöhe=40 mmGerätetiefe=70 mm53,82 €*Versand: 5,99 €Sichere Weiterleitung zum Anbieter
-
Wie können Produkte effizient und präzise etikettiert werden, um eine klare Kennzeichnung und einfache Identifizierung zu gewährleisten?
Produkte können effizient und präzise durch den Einsatz von Etikettiermaschinen mit hoher Geschwindigkeit und Genauigkeit etikettiert werden. Die Verwendung von Barcode- oder RFID-Technologie ermöglicht eine klare Kennzeichnung und einfache Identifizierung der Produkte. Zudem sollte auf eine einheitliche und gut sichtbare Platzierung der Etiketten geachtet werden, um Verwechslungen zu vermeiden. **
-
Was sind die wichtigsten Methoden zur Klassifizierung von Daten?
Die wichtigsten Methoden zur Klassifizierung von Daten sind Supervised Learning, Unsupervised Learning und Semi-Supervised Learning. Supervised Learning verwendet gelabelte Daten, um Modelle zu trainieren, während Unsupervised Learning ungelabelte Daten verwendet, um Muster zu identifizieren. Semi-Supervised Learning kombiniert beide Ansätze und nutzt eine Mischung aus gelabelten und ungelabelten Daten für das Training von Modellen. **
-
Was sind die verschiedenen Methoden zur Klassifizierung von Objekten oder Daten?
Die verschiedenen Methoden zur Klassifizierung von Objekten oder Daten umfassen Supervised Learning, Unsupervised Learning und Semi-Supervised Learning. Beim Supervised Learning werden Trainingsdaten mit bekannten Labels verwendet, um ein Modell zu trainieren. Beim Unsupervised Learning werden keine Labels verwendet, das Modell identifiziert automatisch Muster und Gruppierungen in den Daten. Beim Semi-Supervised Learning werden sowohl gelabelte als auch ungelabelte Daten verwendet, um ein Modell zu trainieren. **
-
Was sind die gängigen Methoden zur Klassifizierung von Objekten oder Daten?
Die gängigen Methoden zur Klassifizierung von Objekten oder Daten sind Supervised Learning, Unsupervised Learning und Semi-Supervised Learning. Supervised Learning verwendet gelabelte Daten, um ein Modell zu trainieren, das dann neue Daten klassifizieren kann. Unsupervised Learning gruppiert Daten basierend auf Ähnlichkeiten, ohne dass gelabelte Daten benötigt werden. Semi-Supervised Learning kombiniert Elemente von Supervised und Unsupervised Learning, indem es sowohl gelabelte als auch ungelabelte Daten verwendet. **
Ähnliche Suchbegriffe für Datenleitungs-Daten
-
Fischer, Tin: Linke Daten, Rechte DatenLinke Daten, Rechte Daten , Warum wir nur das sehen, was wir sehen wollen , Lager, Buchsen & Dichtungen > Radaufhängung, Federung & Lenkung , Erscheinungsjahr: 20220402, Produktform: Leinen, Autoren: Fischer, Tin, Seitenzahl/Blattzahl: 240, Themenüberschrift: BUSINESS & ECONOMICS / Statistics, Keyword: Statistiken; Gefühlte Wahrheit; Wahrheit; Fake News; Gesundheit; Gesellschaft; Grüne; Umwelt; Klima; Wirtschaft; Geld; Politik; Mario Mensch; Wirtschaftsstatistik; Statistik; Einwanderung, Fachschema: Analyse / Datenanalyse~Datenanalyse~Migration (soziologisch)~Wanderung (soziologisch)~Zuwanderung~Forschung (wirtschafts-, sozialwissenschaftlich) / Sozialforschung~Sozialforschung~Empirische Sozialforschung~Sozialforschung / Empirische Sozialforschung~Umwelt / Politik, Wirtschaft, Planung~Ökonometrie~Statistik / Wirtschaftsstatistik~Wirtschaftsstatistik, Fachkategorie: Datenanalyse, allgemein~Sozialforschung und -statistik~Grüne Politik / Ökopolitik / Umweltschutz~Ökonometrie und Wirtschaftsstatistik~Wahrscheinlichkeitsrechnung und Statistik, Warengruppe: HC/Politikwissenschaft/Soziologie/Populäre Darst., Fachkategorie: Migration, Einwanderung und Auswanderung, Thema: Auseinandersetzen, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Hoffmann und Campe Verlag, Verlag: Hoffmann und Campe Verlag, Verlag: Hoffmann und Campe Verlag GmbH, Länge: 215, Breite: 144, Höhe: 26, Gewicht: 402, Produktform: Gebunden, Genre: Sozialwissenschaften/Recht/Wirtschaft, Genre: Sozialwissenschaften/Recht/Wirtschaft, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0002, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 267813525,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Daten-Spürnasen auf SpurensucheDaten-Spürnasen auf Spurensuche , Mit Spannung und Motivation in die Welt der Daten Haben Viertklässler mehr Spiele auf dem Smartphone als Drittklässler? Wie unterscheiden sich Mädchen und Jungen in ihren Hobbys? Brauchen Kinder aus einer Stadt wirklich länger zur Schule als Kinder aus einem Dorf? Daten-Spürnasen finden die Antworten! Bereits Grundschülerinnen und -schüler können in die Rolle von Daten-Spürnasen schlüpfen. Das zeigt dieses Buch. Die Kinder sammeln Daten, betrachten sie unter verschiedenen Perspektiven und finden die Informationen hinter den Daten. Dabei durchlaufen sie den kompletten Zyklus eines statistischen Projekts: von der Fragestellung über die Erhebung bis hin zur Auswertung. Der Einsatz digitaler Werkzeuge unterstützt die Schülerinnen und Schüler, auch umfangreiche Daten unter eigenen Fragestellungen zu untersuchen. An motivierenden und lebensnahen Themen eignen sie sich so nachhaltige Kompetenzen aus dem Inhaltsbereich "Daten, Häufigkeit, Wahrscheinlichkeit" an. "Daten-Spürnasen auf Spurensuche" gibt Orientierung und praxisnahe Anregungen durch: - erprobte Unterrichtssequenzen zur Datenanalyse - mit und ohne digitale Werkzeuge - von Klasse 2 bis 4, - zahlreiche Unterrichtsmaterialien (Arbeitsblätter, Datenkarten, Datensätze) im Buch und als Download, - didaktisch-methodische Informationen zur professionellen Vorbereitung und Durchführung des Unterrichts, - eine Einführung in die Datenanalyse mit der Software TinkerPlots Zielgruppe dieses Buchs sind interessierte Lehrkräfte für Mathematik und Sachunterricht an Grundschulen, Studierende und Referendare sowie Lehrerfortbildner*innen. , Zündspulen > Elektrik & Zündungen , Erscheinungsjahr: 20240821, Produktform: Kartoniert, Redaktion: Biehler, Rolf~Frischemeier, Daniel, Seitenzahl/Blattzahl: 221, Keyword: Daten; Häufigkeit; Wahrscheinlichkeit, Fachschema: Mathematik / Lehrermaterial~Mathematik / Statistik, Bildungsmedien Fächer: Mathematik, Algebra, Geometrie, Bildungszweck: für den Primarbereich~Für die Vorschule (Deutschland), Altersempfehlung / Lesealter: 23, Genaues Alter: GRS, Warengruppe: HC/Schulbücher/Unterrichtsmat./Lehrer, Fachkategorie: Unterricht und Didaktik: Mathematik, Schulform: GRS, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Kallmeyer'sche Verlags-, Verlag: Kallmeyer'sche Verlags-, Verlag: Kallmeyer'sche Verlagsbuchhandlung, Länge: 226, Breite: 162, Höhe: 15, Gewicht: 389, Produktform: Klappenbroschur, Genre: Schule und Lernen, Genre: Schule und Lernen, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Kennzeichnung von Titeln mit einer Relevanz > 30, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Schulform: Grundschule, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, Unterkatalog: Schulbuch,29,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die gängigsten Methoden zur Klassifizierung von Daten in der Informatik?
Die gängigsten Methoden zur Klassifizierung von Daten in der Informatik sind die hierarchische Klassifizierung, die kategorische Klassifizierung und die numerische Klassifizierung. Bei der hierarchischen Klassifizierung werden Daten in einer Baumstruktur organisiert, bei der kategorischen Klassifizierung werden Daten in verschiedene Kategorien eingeteilt und bei der numerischen Klassifizierung werden Daten anhand von Zahlenwerten klassifiziert. **
-
Was sind die verschiedenen Methoden zur Klassifizierung von Daten in der Informatik?
Die verschiedenen Methoden zur Klassifizierung von Daten in der Informatik sind Supervised Learning, Unsupervised Learning und Semi-Supervised Learning. Beim Supervised Learning werden Daten mit bereits bekannten Labels trainiert, beim Unsupervised Learning werden Muster und Strukturen in den Daten identifiziert, und beim Semi-Supervised Learning werden sowohl gelabelte als auch ungelabelte Daten verwendet. Jede Methode hat ihre eigenen Vor- und Nachteile und wird je nach Anwendungsfall ausgewählt. **
-
Was sind die gängigsten Methoden zur Klassifizierung von Daten in der Informatik?
Die gängigsten Methoden zur Klassifizierung von Daten in der Informatik sind die hierarchische Klassifizierung, die k-means-Clustering-Methode und die Entscheidungsbaum-Methode. Bei der hierarchischen Klassifizierung werden Daten in hierarchische Gruppen unterteilt, während bei k-means Daten in k Gruppen mit ähnlichen Merkmalen eingeteilt werden. Die Entscheidungsbaum-Methode teilt Daten basierend auf Entscheidungen in einem Baumdiagramm auf. **
-
Was sind die gängigsten Methoden zur Klassifizierung von Daten in der Informatik?
Die gängigsten Methoden zur Klassifizierung von Daten in der Informatik sind die Supervised Learning, Unsupervised Learning und Semi-Supervised Learning. Supervised Learning verwendet gelabelte Daten, um Muster zu erkennen und Vorhersagen zu treffen. Unsupervised Learning findet Muster in unlabeled Daten, während Semi-Supervised Learning eine Kombination aus beidem ist. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.